
رقابت تراشههای هوش مصنوعی؛ چرا غولهای فناوری پردازنده اختصاصی میسازند؟
هوش مصنوعی دیگر فقط یک فناوری نرمافزاری نیست؛ بلکه به یکی از مهمترین عوامل تحول در زیرساختهای سختافزاری، شبکه و دیتاسنترها تبدیل شده است. از اجرای مدلهای زبانی بزرگ گرفته تا توسعه دستیارهای هوشمند، تحلیل دادههای سازمانی و ساخت عاملهای خودکار هوش مصنوعی، همه این فناوریها به قدرت پردازشی، حافظه پرسرعت، شبکه قدرتمند و زیرساختی پایدار نیاز دارند.
در این میان، رقابت تراشههای هوش مصنوعی به یکی از مهمترین موضوعات صنعت فناوری تبدیل شده است. شرکتهایی مانند NVIDIA، Microsoft، Google و Amazon علاوه بر توسعه نرمافزارها و سرویسهای هوش مصنوعی، سرمایهگذاری گستردهای روی طراحی و استفاده از پردازندهها و شتابدهندههای اختصاصی انجام میدهند.
اما چرا غولهای فناوری ترجیح میدهند بهجای تکیه کامل بر پردازندههای عمومی بازار، تراشههای اختصاصی خودشان را توسعه دهند؟ آیا این روند میتواند هزینه سرورهای هوش مصنوعی را کاهش دهد؟ و مهمتر از همه، رقابت بر سر پردازندههای هوش مصنوعی چه تأثیری بر آینده سرور، تجهیزات شبکه، ذخیرهسازی و زیرساخت دیتاسنترهای سازمانی خواهد داشت؟
در این مقاله از فاواجم، دلایل این رقابت، تفاوت انواع پردازندههای هوش مصنوعی و تأثیر آن بر آینده زیرساخت فناوری اطلاعات را بررسی میکنیم.
تراشه هوش مصنوعی چیست و چرا اهمیت دارد؟
تراشه هوش مصنوعی نوعی پردازنده یا شتابدهنده سختافزاری است که برای انجام محاسبات موردنیاز الگوریتمهای یادگیری ماشین و هوش مصنوعی به کار میرود. این تراشهها میتوانند برای آموزش مدلها، اجرای مدلهای آموزشدیده، پردازش تصاویر، تحلیل دادهها و انجام محاسبات موازی بهینهسازی شده باشند.
برای درک بهتر اهمیت این فناوری، کافی است یک سرویس هوش مصنوعی را در نظر بگیریم که همزمان به هزاران یا میلیونها کاربر پاسخ میدهد. در پشت صحنه، مجموعهای از سرورها، پردازندهها، حافظهها، تجهیزات شبکه و سامانههای خنککننده فعالیت میکنند تا درخواست کاربران با سرعت و دقت مناسب پردازش شود.
هرچه تعداد کاربران و پیچیدگی مدلهای هوش مصنوعی افزایش یابد، فشار بیشتری به این زیرساخت وارد خواهد شد. به همین دلیل، انتخاب پردازنده مناسب دیگر فقط به قدرت محاسباتی محدود نیست؛ بلکه مصرف انرژی، پهنای باند حافظه، هزینه مالکیت، سازگاری نرمافزاری و توانایی مقیاسپذیری نیز اهمیت زیادی دارند.
در چنین شرایطی، تراشههای اختصاصی میتوانند به شرکتهای بزرگ کمک کنند تا سختافزار را متناسب با نوع سرویس و حجم واقعی پردازشهای خود طراحی کنند.
چرا شرکتهای بزرگ فناوری به دنبال ساخت پردازنده اختصاصی هستند؟
توسعه تراشه اختصاصی پروژهای پیچیده، پرهزینه و زمانبر است. با این حال، شرکتهایی که حجم بسیار زیادی از پردازشهای هوش مصنوعی را در دیتاسنترهای خود انجام میدهند، ممکن است از طراحی سختافزار اختصاصی سود قابل توجهی به دست آورند.
۱. کاهش هزینه پردازش هوش مصنوعی
یکی از مهمترین دلایل توسعه پردازنده اختصاصی، کاهش هزینه پردازش در مقیاس بزرگ است.
زمانی که یک شرکت میلیونها درخواست هوش مصنوعی را در طول روز پردازش میکند، حتی کاهش اندک هزینه هر درخواست میتواند در مجموع صرفهجویی قابلتوجهی ایجاد کند. طراحی تراشه متناسب با یک وظیفه مشخص، حذف بخشهای غیرضروری و بهینهسازی ارتباط پردازنده با حافظه میتواند به بهبود بهرهوری منجر شود.
البته ساخت تراشه اختصاصی لزوماً در تمام شرایط ارزانتر نیست. هزینه طراحی، تولید، آزمایش، توسعه نرمافزار و نگهداری نیز باید در محاسبه هزینه کل مالکیت در نظر گرفته شود.
۲. کاهش مصرف انرژی و فشار بر دیتاسنتر
مصرف برق یکی از محدودیتهای مهم در توسعه دیتاسنترهای هوش مصنوعی است. افزایش تعداد شتابدهندهها، سرورها و تجهیزات شبکه باعث افزایش نیاز به برق و خنکسازی میشود.
در نتیجه، شرکتها به دنبال سختافزاری هستند که بتواند با مصرف انرژی مشخص، تعداد بیشتری عملیات مفید انجام دهد.
معیارهایی مانند عملکرد بهازای هر وات، تعداد توکن پردازششده بهازای انرژی مصرفی و کارایی در بار کاری واقعی، در ارزیابی شتابدهندههای هوش مصنوعی اهمیت دارند.
بهبود این معیارها میتواند ظرفیت قابلاستفاده دیتاسنتر را افزایش دهد؛ هرچند میزان صرفهجویی واقعی به نوع پردازش، پیکربندی سرور، سامانه خنککننده و شرایط عملیاتی بستگی دارد.
۳. کنترل بیشتر بر طراحی سختافزار و نرمافزار
شرکتهای بزرگ فناوری معمولاً اطلاعات دقیقی از نوع پردازشهای سرویسهای خود دارند. برای مثال، یک سرویس تولید متن ممکن است به الگوی متفاوتی از حافظه و پردازش نسبت به یک سامانه تحلیل تصویر نیاز داشته باشد.
با طراحی تراشه اختصاصی، امکان هماهنگی بهتر میان پردازنده، حافظه، شبکه، سیستمعامل و نرمافزارهای هوش مصنوعی فراهم میشود.
این هماهنگی میتواند تأخیر پردازش را کاهش دهد، بهره وری منابع را بهبود دهد و استفاده از سختافزار را متناسب با نیاز واقعی سرویس امکانپذیر کند.
۴. کاهش وابستگی به تأمینکنندگان سختافزار
در بازار پردازندههای هوش مصنوعی، دسترسی به سختافزار مناسب و زمان تحویل آن میتواند بر برنامه توسعه شرکتها تأثیر بگذارد.
طراحی تراشه اختصاصی به شرکتهای بزرگی مانند مایکروسافت، گوگل و آمازون امکان میدهد بخشی از نیازهای پردازشی خود را با راهکارهای داخلی تأمین کنند.
البته این موضوع به معنای استقلال کامل نیست؛ زیرا تولید تراشه همچنان به زنجیره تأمین نیمهرساناها، کارخانههای پیشرفته، تجهیزات ساخت و تأمین حافظه وابسته است.
۵. ایجاد مزیت رقابتی در خدمات ابری
شرکتهایی که خدمات ابری و هوش مصنوعی ارائه میدهند، باید میان سرعت پاسخگویی، کیفیت سرویس، هزینه پردازش و ظرفیت توسعه تعادل ایجاد کنند.
اگر یک شرکت بتواند مدلهای هوش مصنوعی را با هزینه کمتر یا سرعت بیشتر اجرا کند، ممکن است خدمات رقابتیتری به مشتریان ارائه دهد.
به همین دلیل، تراشه اختصاصی صرفاً یک قطعه سختافزاری نیست؛ بلکه بخشی از راهبرد تجاری شرکتهای بزرگ فناوری محسوب میشود.
تفاوت CPU، GPU و شتابدهنده اختصاصی هوش مصنوعی چیست؟
برای شناخت بهتر رقابت تراشههای هوش مصنوعی، باید تفاوت سه گروه اصلی پردازندهها را بدانیم.
پردازنده مرکزی یا CPU
CPU یا Central Processing Unit برای اجرای طیف گستردهای از وظایف عمومی طراحی شده است. اجرای سیستمعامل، مدیریت فرایندها، پردازش منطق برنامهها، هماهنگی میان اجزای سرور و اجرای بسیاری از سرویسهای سازمانی از وظایف این پردازنده است.
در سرورهای هوش مصنوعی نیز CPU نقش مهمی در مدیریت سیستم، آمادهسازی دادهها، اجرای سرویسهای جانبی و هماهنگی با شتابدهندهها دارد.
بنابراین، گسترش هوش مصنوعی به معنای حذف CPU نیست؛ بلکه معمولاً به همکاری پردازنده مرکزی با شتابدهندههای تخصصی نیاز دارد.
پردازنده گرافیکی یا GPU
GPU در ابتدا برای پردازش گرافیکی توسعه یافت، اما معماری آن برای بسیاری از محاسبات موازی نیز بسیار مناسب است.
آموزش مدلهای یادگیری عمیق و اجرای بسیاری از مدلهای بزرگ هوش مصنوعی به انجام تعداد زیادی عملیات ریاضی وابسته است. GPUها میتوانند این عملیات را به شکل موازی اجرا کنند و به همین دلیل در زیرساخت هوش مصنوعی نقش مهمی دارند.
NVIDIA علاوه بر تولید GPU، مجموعهای از ابزارها و کتابخانههای نرمافزاری مانند CUDA را توسعه داده است. این اکوسیستم یکی از عوامل مهم در گسترش استفاده از پردازندههای این شرکت در محاسبات علمی و هوش مصنوعی بوده است.
با این حال، عملکرد واقعی GPU به مدل مورد استفاده، حجم حافظه، پهنای باند، نرمافزار و پیکربندی کل سیستم وابسته است.
شتابدهنده اختصاصی یا ASIC
ASIC مخفف Application-Specific Integrated Circuit است؛ یعنی مدار مجتمع طراحیشده برای کاربردی مشخص.
این تراشهها میتوانند برای نوع معینی از محاسبات بهینهسازی شوند و در صورت تطابق طراحی با بار کاری، عملکرد و بهرهوری انرژی مناسبی ارائه دهند.
Google TPU و خانواده شتابدهندههای هوش مصنوعی اختصاصی شرکتهای ابری نمونههایی از این رویکرد هستند.
البته تراشه اختصاصی ممکن است نسبت به GPU عمومی انعطافپذیری کمتری داشته باشد یا برای استفاده مؤثر به ابزارها و نرمافزارهای خاص نیازمند باشد. بنابراین، انتخاب آن باید براساس نیاز واقعی و سازگاری با محیط نرمافزاری انجام شود.
جدول مقایسه CPU، GPU و ASIC
ویژگی | CPU | GPU | ASIC یا شتابدهنده اختصاصی |
کاربرد اصلی | پردازش عمومی و مدیریت سیستم | محاسبات موازی | بارهای کاری مشخص |
انعطافپذیری | بالا | بالا تا متوسط، بسته به نرمافزار | وابسته به طراحی |
کاربرد در هوش مصنوعی | مدیریت و اجرای وظایف عمومی | آموزش و اجرای بسیاری از مدلها | اجرای بهینه وظایف هدف |
اکوسیستم نرمافزاری | گسترده | وابسته به سازنده و پلتفرم | وابسته به ابزارهای اختصاصی |
معیار مهم انتخاب | عملکرد عمومی و تعداد هستهها | توان پردازش، حافظه و نرمافزار | بهرهوری برای بار کاری مشخص |
هیچکدام از این سه گروه در تمام سناریوها بهترین انتخاب نیستند. در بسیاری از دیتاسنترها، معماری مناسب ترکیبی از CPU، GPU، شتابدهنده اختصاصی، حافظه پرسرعت و شبکه با پهنای باند بالاست.
آموزش مدل هوش مصنوعی با اجرای مدل چه تفاوتی دارد؟
یکی از مفاهیم مهم در بررسی تراشههای هوش مصنوعی، تفاوت میان آموزش مدل و استنتاج یا Inference است.
آموزش مدل (Training)
در مرحله آموزش، مدل با استفاده از حجم زیادی از دادهها تنظیم میشود تا الگوها و روابط موردنیاز را یاد بگیرد. این مرحله ممکن است به محاسبات سنگین، حافظه زیاد، ارتباط پرسرعت میان پردازندهها و زمان اجرای طولانی نیاز داشته باشد.
برای آموزش مدلهای بزرگ، معمولاً از مجموعهای از شتابدهندهها استفاده میشود که از طریق شبکه پرسرعت به یکدیگر متصل هستند.
اجرای مدل یا استنتاج (Inference)
در مرحله استنتاج، مدل آموزشدیده برای پاسخگویی به درخواست کاربران یا انجام یک وظیفه مشخص به کار میرود.
برای مثال، هنگامی که کاربر سؤالی از یک دستیار هوشمند میپرسد، سامانه باید ورودی را پردازش کند و پاسخ مناسب را تولید کند. این فرایند نمونهای از استنتاج است.
در مقیاس بزرگ، سرعت پاسخگویی، تعداد درخواستهای همزمان، مصرف انرژی، ظرفیت حافظه و هزینه پردازش هر درخواست اهمیت زیادی دارند.
به همین دلیل، برخی شتابدهندههای اختصاصی بهطور ویژه برای استنتاج بهینهسازی میشوند. این رویکرد میتواند برای شرکتهایی که حجم بسیار زیادی از درخواستهای تکرارشونده را پردازش میکنند، مزیت ایجاد کند.
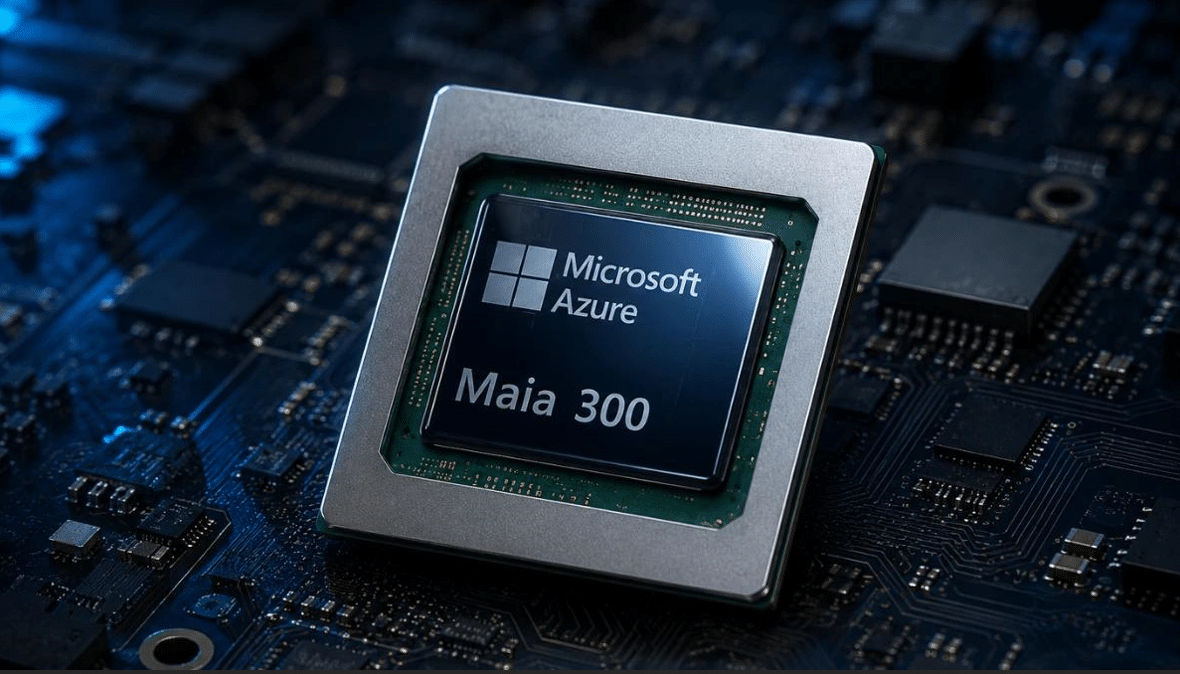
Azure Maia 300؛ گام جدید مایکروسافت در رقابت تراشههای هوش مصنوعی
مایکروسافت در ۱۲ اکتبر ۲۰۲۶ از نسل جدید شتابدهنده اختصاصی خود با نام Azure Maia 300 خبر داد. براساس اعلام رسمی این شرکت، Maia 300 با تمرکز بر اجرای مدلهای هوش مصنوعی و بارهای کاری پیچیدهتر طراحی شده است و قرار است استقرار تولیدی آن از سال ۲۰۲۷ آغاز شود.
نکته مهم این است که مایکروسافت Maia 300 را بخشی از یک سامانه کامل معرفی میکند؛ سامانهای که تراشه، حافظه، شبکه، نرمافزار، طراحی رک و زیرساخت دیتاسنتر در آن با یکدیگر هماهنگ شدهاند.
مهمترین ویژگیهای اعلامشده Maia 300
۱. تمرکز بر استنتاج هوش مصنوعی
Maia 300 برای بارهای کاری استنتاج، از جمله پردازش درخواستهای پیچیده، تعاملات مکالمهای حساس به تأخیر و اجرای وظایف چندمرحلهای عاملهای هوش مصنوعی طراحی شده است.
۲. هدفگذاری برای افزایش بهرهوری انرژی
مایکروسافت اعلام کرده است که این سامانه در مقایسه با سیستمهای مرجع مبتنی بر GPU که شرکت برای مقایسه انتخاب کرده، انتظار دارد به ازای هر مگاوات ۴۰ درصد توکن بیشتری پردازش کند.
این عدد، ادعای اعلامشده از سوی مایکروسافت است و نباید آن را به معنای کاهش تضمینشده ۴۰ درصدی قبض برق یا هزینه کل دیتاسنتر در نظر گرفت.
۳. توان عملیاتی بالاتر در مقیاس رک
براساس اعلام رسمی شرکت، پیکربندی کامل Maia 300 با ۹۶ شتابدهنده میتواند تا هفت برابر توان عملیاتی توکن در مقیاس رک نسبت به Maia 200 ارائه دهد.
این مقایسه به پیکربندی مشخص اعلامشده مربوط است و به معنای سریعتر بودن Maia 300 در همه کاربردها یا در مقایسه با تمام GPUهای بازار نیست.
۴. آغاز استقرار تولیدی از سال ۲۰۲۷
برنامه اعلامشده مایکروسافت این است که استقرار تولیدی Maia 300 از سال ۲۰۲۷ آغاز شود. در همین حال، این شرکت اعلام کرده که Maia 200 وارد استفاده عملیاتی شده و در پردازش برخی بارهای کاری سرویسهایش به کار میرود.
برای بررسی مشخصات و جزئیات فنی بیشتر، میتوانید به اطلاعیه رسمی مایکروسافت درباره Azure Maia و مقاله فنی معماری Maia 300 مراجعه کنید.
چرا این خبر برای بازار زیرساخت اهمیت دارد؟
اهمیت Maia 300 فقط به طراحی یک تراشه جدید محدود نیست. این محصول نشان میدهد که رقابت هوش مصنوعی به سمت بهینهسازی کل سامانه حرکت میکند؛ یعنی عملکرد تراشه باید در کنار حافظه، شبکه، برق و خنکسازی بررسی شود.
برای مثال، اگر یک شتابدهنده بتواند محاسبات را سریعتر انجام دهد اما شبکه نتواند داده را با سرعت کافی منتقل کند، بخشی از ظرفیت پردازشی بدون استفاده خواهد ماند.
به همین ترتیب، افزایش تعداد شتابدهندهها بدون توجه به ظرفیت برق و خنکسازی میتواند محدودیتهای عملیاتی جدی ایجاد کند.
بنابراین، آینده دیتاسنترهای هوش مصنوعی به طراحی هماهنگ تمام اجزای زیرساخت وابسته است.
رقابت NVIDIA، Google، Microsoft و Amazon چه معنایی دارد؟
بازار تراشههای هوش مصنوعی به یک شرکت یا یک معماری محدود نیست. بازیگران بزرگ این حوزه رویکردهای متفاوتی را دنبال میکنند.
NVIDIA؛ ترکیب سختافزار و نرمافزار
NVIDIA با GPUهای مورد استفاده در آموزش و اجرای مدلهای هوش مصنوعی و اکوسیستم نرمافزاری CUDA جایگاه مهمی در بازار دارد.
مزیت این شرکت تنها به توان محاسباتی تراشه محدود نمیشود؛ ابزارهای توسعه، کتابخانهها، پشتیبانی نرمافزاری و راهکارهای شبکه نیز در انتخاب محصولات آن نقش دارند.
Google؛ توسعه شتابدهندههای TPU
گوگل خانواده TPU را برای تسریع بارهای کاری یادگیری ماشین توسعه داده است. این شتابدهندهها در زیرساختهای هوش مصنوعی گوگل و خدمات ابری آن نقش دارند.
هدف از این رویکرد، هماهنگی بهتر میان سختافزار، چارچوبهای نرمافزاری و نیازهای پردازشی سرویسهای گوگل است.
Amazon؛ شتابدهندههای Trainium و Inferentia
آمازون نیز از طریق خانواده شتابدهندههای اختصاصی خود، از جمله Trainium و Inferentia، به دنبال بهینهسازی آموزش و اجرای مدلهای هوش مصنوعی در زیرساخت ابری AWS است.
این محصولات برای بارهای کاری مشخص طراحی شدهاند و انتخاب آنها به مدل، ابزارهای نرمافزاری و نیازهای عملیاتی مشتری بستگی دارد.
Microsoft؛ توسعه خانواده Azure Maia
مایکروسافت با خانواده Maia تلاش میکند بخشی از نیازهای پردازشی سرویسهای هوش مصنوعی خود را با سختافزار اختصاصی تأمین کند.
این شرکت همچنان میتواند از ترکیبی از GPUها و شتابدهندههای مختلف استفاده کند. بنابراین، توسعه تراشه اختصاصی را نباید به معنای کنار گذاشتن کامل محصولات NVIDIA یا سایر تأمینکنندگان دانست.
در مجموع، رقابت این شرکتها نشان میدهد که آینده بازار احتمالاً به سمت زیرساختهای متنوعتر و ترکیبی حرکت خواهد کرد؛ زیرساختهایی که هر بخش از آن متناسب با نوع بار کاری انتخاب میشود.
تأثیر رقابت تراشههای هوش مصنوعی بر سرورها
با افزایش استفاده از هوش مصنوعی، سرورها باید بتوانند حجم بیشتری از دادهها را پردازش کنند و با شتابدهندهها، حافظه و شبکه ارتباط مؤثری داشته باشند.
در یک سرور هوش مصنوعی، صرفاً انتخاب قویترین پردازنده کافی نیست. تعداد اسلاتهای توسعه، پشتیبانی از شتابدهندهها، ظرفیت حافظه، پهنای باند ارتباطی، توان منبع تغذیه و قابلیت خنکسازی هم اهمیت دارند.
در برخی کاربردها، سرورهای مجهز به GPU برای آموزش یا اجرای مدلهای بزرگ مناسب هستند. در کاربردهای دیگر، سرورهای مبتنی بر CPU یا سامانههای دارای شتابدهنده اختصاصی ممکن است پاسخگوی نیاز باشند.
به همین دلیل، سازمانها پیش از خرید سرور باید نوع مدل، تعداد کاربران همزمان، حجم داده، زمان پاسخگویی مورد انتظار و برنامه توسعه آینده را مشخص کنند.
انتخاب درست سرور میتواند از هزینه اضافی برای سختافزار غیرضروری جلوگیری کند و امکان توسعه مرحلهای زیرساخت را فراهم سازد.
چرا شبکه در دیتاسنترهای هوش مصنوعی اهمیت بیشتری پیدا میکند؟
یکی از اشتباهات رایج در طراحی زیرساخت هوش مصنوعی، تمرکز بیش از حد بر پردازنده و نادیده گرفتن شبکه است.
هنگامی که تعداد زیادی شتابدهنده در چندین سرور فعالیت میکنند، انتقال داده میان آنها میتواند به یکی از عوامل تعیینکننده عملکرد تبدیل شود.
در چنین محیطی، موارد زیر اهمیت ویژهای دارند:
- پهنای باند کافی برای انتقال داده میان سرورها و سامانههای ذخیرهسازی
- تأخیر پایین در ارتباطات حساس به زمان
- سوئیچهای مناسب برای ترافیک سنگین دیتاسنتر
- طراحی صحیح توپولوژی شبکه و مسیرهای ارتباطی
- بررسی تراکم ترافیک، افزونگی و نقاط گلوگاهی
- انتخاب زیرساخت فیبر نوری و اتصالات متناسب با سرعت موردنیاز
در برخی معماریهای هوش مصنوعی، ارتباطات پرسرعت میان شتابدهندهها بهاندازه قدرت محاسباتی اهمیت پیدا میکند. اگر شبکه نتواند داده را بهموقع منتقل کند، شتابدهندهها ممکن است برای دریافت اطلاعات منتظر بمانند.
به همین دلیل، توسعه زیرساخت هوش مصنوعی میتواند تقاضا برای تجهیزات شبکه دیتاسنتری و راهکارهای ارتباطی پرسرعت را افزایش دهد.
نقش حافظه و ذخیرهسازی در زیرساخت هوش مصنوعی
پردازنده قدرتمند بدون دسترسی مناسب به داده نمیتواند حداکثر کارایی خود را ارائه دهد.
در سیستمهای هوش مصنوعی، حافظه پرسرعت برای نگهداری دادهها و پارامترهای موردنیاز پردازش اهمیت دارد. در سطحی دیگر، ذخیرهسازی باید بتواند مجموعهدادهها، فایلهای آموزشی، خروجی مدلها، نسخههای پشتیبان و اطلاعات عملیاتی را مدیریت کند.
بسته به نوع کاربرد، زیرساخت ذخیرهسازی ممکن است به ظرفیت بالا، تأخیر کم، توان خواندن و نوشتن مناسب یا دسترسی همزمان چندین سرور نیاز داشته باشد.
در این بخش باید میان حافظهای مانند HBM که نزدیک شتابدهنده قرار دارد و سامانه ذخیرهسازی سازمانی تفاوت قائل شد. این دو جایگزین مستقیم یکدیگر نیستند و نقشهای متفاوتی در معماری سیستم دارند.
برای سازمانهایی که زیرساخت داده خود را توسعه میدهند، انتخاب ترکیبی مناسب از سرور، ذخیرهسازی پرسرعت، ذخیرهسازی ظرفیتمحور و شبکه میتواند اهمیت زیادی داشته باشد.
تأثیر تراشههای هوش مصنوعی بر برق و خنکسازی دیتاسنتر
هرچه تراکم پردازشی در رکها افزایش پیدا کند، مدیریت انرژی و دفع گرما دشوارتر میشود.
در دیتاسنترهای متراکم، طراحی برقرسانی، توزیع بار، ظرفیت منبع تغذیه، جریان هوای مناسب و در موارد لازم خنکسازی مایع باید از ابتدا مورد توجه قرار گیرد.
این موضوع بهویژه زمانی اهمیت دارد که چندین شتابدهنده پرمصرف در یک سرور یا رک نصب میشوند.
پیش از توسعه زیرساخت هوش مصنوعی، لازم است ظرفیت برق قابلدسترس، محدودیتهای کف و رک، توان خنکسازی و امکان توسعه آینده بررسی شود.
بنابراین، خرید شتابدهنده قدرتمند بدون ارزیابی ظرفیت برق و خنکسازی میتواند باعث افزایش هزینه یا محدود شدن عملکرد سیستم شود.
آیا رقابت تراشههای هوش مصنوعی باعث ارزانتر شدن سختافزار میشود؟
پاسخ این پرسش قطعی نیست. رقابت بیشتر میتواند در بلندمدت به افزایش انتخابها، بهبود بهرهوری و ایجاد راهکارهای متنوعتر منجر شود؛ اما لزوماً به معنای کاهش فوری قیمت تمام تجهیزات نیست.
قیمت نهایی زیرساخت هوش مصنوعی به عوامل مختلفی وابسته است:
- هزینه طراحی و تولید تراشه
- دسترسی به شتابدهندهها و حافظههای پیشرفته
- هزینه سرور، شبکه و تجهیزات جانبی
- مصرف برق و هزینه خنکسازی
- هزینه نرمافزار، مجوزها و پشتیبانی
- مقیاس پروژه و میزان استفاده واقعی از منابع
در برخی پروژهها، شتابدهنده اختصاصی ممکن است هزینه پردازش را کاهش دهد. در پروژههای دیگر، هزینه انتقال به معماری جدید، سازگاری نرمافزاری یا کمبود ابزارهای تخصصی میتواند این مزیت را محدود کند.
برای همین، معیار مناسب انتخاب زیرساخت فقط قیمت خرید سختافزار نیست؛ بلکه باید هزینه کل مالکیت و عملکرد واقعی در طول عمر سیستم بررسی شود.
سازمانها برای آماده شدن در برابر موج هوش مصنوعی چه کاری انجام دهند؟
همه سازمانها به دیتاسنتر مجهز به شتابدهندههای اختصاصی نیاز ندارند. بسیاری از کسبوکارها میتوانند از سرویسهای ابری یا سرورهای متناسب با نیازهای فعلی خود استفاده کنند.
با این حال، پیش از توسعه زیرساخت، بهتر است چند موضوع مشخص شود:
۱. تعیین نوع کاربرد: آیا هدف اجرای مدل زبانی، تحلیل تصویر، پردازش اسناد یا استفاده از دستیار هوشمند است؟
۲. برآورد بار کاری: تعداد کاربران، حجم درخواستها، اندازه مدل و زمان پاسخگویی موردنیاز چقدر است؟
۳. انتخاب معماری مناسب: آیا CPU کافی است یا به GPU و شتابدهنده اختصاصی نیاز وجود دارد؟
۴. بررسی شبکه و ذخیرهسازی: آیا زیرساخت فعلی توان انتقال و نگهداری دادههای موردنیاز را دارد؟
۵. ارزیابی برق و خنکسازی: آیا ظرفیت زیرساخت برای توسعه پردازشی بیشتر مناسب است؟
۶. برنامهریزی برای توسعه آینده: آیا امکان افزایش حافظه، ظرفیت ذخیرهسازی، پهنای باند شبکه و توان پردازشی وجود دارد؟
۷. محاسبه هزینه کل مالکیت: هزینه خرید، راهاندازی، نگهداری، مصرف انرژی و پشتیبانی باید در کنار هم بررسی شوند.
اجرای این مراحل کمک میکند تصمیمگیری درباره خرید سرور و تجهیزات دیتاسنتر بر پایه نیاز واقعی انجام شود، نه صرفاً بر اساس مشخصات تبلیغاتی یک پردازنده.
آینده رقابت تراشههای هوش مصنوعی چگونه خواهد بود؟
به نظر میرسد رقابت آینده فقط بر سر ساخت پردازندهای با قدرت محاسباتی بیشتر نباشد. بهرهوری انرژی، ظرفیت و پهنای باند حافظه، سرعت ارتباطات، پشتیبانی نرمافزاری و هزینه اجرای هر درخواست نیز نقش تعیینکنندهای خواهند داشت.
همچنین، با گسترش عاملهای هوش مصنوعی و مدلهای دارای پنجره متنی بزرگتر، زیرساختها باید بتوانند تعداد بیشتری از درخواستها و فرایندهای چندمرحلهای را مدیریت کنند.
در چنین شرایطی، احتمالاً شاهد استفاده گستردهتر از معماریهای ترکیبی خواهیم بود؛ معماریهایی که در آنها CPU، GPU و شتابدهندههای اختصاصی در کنار شبکه و ذخیرهسازی متناسب با نیاز هر بار کاری به کار گرفته میشوند.
برای بازار تجهیزات فناوری اطلاعات نیز این تحول اهمیت زیادی دارد. افزایش ظرفیت پردازشی میتواند نیاز به سرورهای تخصصیتر، شبکههای پرسرعت، ذخیرهسازی مناسب و طراحی اصولیتر دیتاسنتر را افزایش دهد.
با این حال، میزان رشد تقاضا و تأثیر آن بر قیمت تجهیزات به روند بازار، دسترسی به قطعات و شرایط زنجیره تأمین وابسته خواهد بود.
جمعبندی: تراشه اختصاصی تنها بخشی از آینده هوش مصنوعی است
رقابت تراشههای هوش مصنوعی نشان میدهد که شرکتهای بزرگ فناوری برای افزایش بهرهوری و کنترل بهتر هزینهها، به دنبال هماهنگی بیشتر میان سختافزار و نرمافزار هستند.
NVIDIA با GPUها و اکوسیستم نرمافزاری خود، گوگل با TPU، آمازون با خانواده شتابدهندههای اختصاصی و مایکروسافت با Azure Maia، رویکردهای متفاوتی را برای پاسخ به نیازهای روبهرشد هوش مصنوعی دنبال میکنند.
با وجود این، هیچ تراشهای بهتنهایی تضمینکننده عملکرد مطلوب نیست. سرور، حافظه، شبکه، ذخیرهسازی، برق، خنکسازی و نرمافزار همگی باید بهصورت یکپارچه طراحی و انتخاب شوند.
برای سازمانهایی که قصد توسعه زیرساخت فناوری اطلاعات یا ورود به حوزه هوش مصنوعی را دارند، شناخت این تغییرات میتواند به انتخاب آگاهانهتر تجهیزات و کاهش هزینههای بلندمدت کمک کند.
فاواجم؛ همراه شما در طراحی و تأمین زیرساخت فناوری اطلاعات
اگر برای توسعه شبکه سازمانی، انتخاب سرور، تجهیزات ذخیرهسازی یا ارتقای زیرساخت دیتاسنتر خود به مشاوره نیاز دارید، میتوانید با کارشناسان فاواجم تماس بگیرید تا متناسب با نیاز فنی و بودجه پروژه، راهکار مناسب را بررسی کنید.
شماره تماس فاواجم: